Fachtests und Nutzerwertungen stimmen kaum überein
Viele Sterne bedeuten nicht automatisch ein gutes Testergebnis. Wir haben für 220 Modelle aus 19 Rubriken verglichen, wie Fachredaktionen und Bewertende dasselbe Produkt einordnen. Innerhalb einer Rubrik ist ein Zusammenhang zwischen beiden Urteilen kaum messbar. Wir testen nichts selbst: Die Zahlen stammen aus 444 veröffentlichten Tests und den Wertungen auf Händlerseiten.
Stand: 06.11.2026.
Das Ergebnis in fünf Zahlen
- 52 %: Nimmt man zwei zufällige Modelle derselben Rubrik, hat das mit den besseren Sternen in 52 % der Fälle auch den besseren Testwert (95-%-Intervall 45 % bis 59 %). Ein Münzwurf läge bei 50 %, das Intervall schließt ihn ein.
- 0,08 beträgt die Rangkorrelation zwischen Testergebnis und Nutzerwertung innerhalb derselben Rubrik (95-%-Intervall −0,06 bis 0,22, 203 Modelle). 0 hieße kein Zusammenhang, 1 dieselbe Reihenfolge. Auch das ist vom Zufall kaum zu unterscheiden.
- 35 % der Modelle aus dem besten Testdrittel einer Rubrik stehen auch bei Bewertenden im oberen Drittel, 31 % im unteren. Ganz ohne Zusammenhang wären es je 33 %.
- 0,22 erreichen zwei unabhängige Testredaktionen untereinander, ein einzelner Test und die Nutzerwertungen auf denselben 106 Modellen 0,07. Dieser Abstand ist statistisch nicht gesichert. Nutzerwertungen auf zwei verschiedenen Plattformen kommen auf 0,47 (89 Modelle).
- 90 % der Modelle haben 4,0 Sterne oder mehr. Die Sterne trennen hier also wenig: Die mittleren 80 % liegen zwischen 4,0 und 4,7 Sternen.

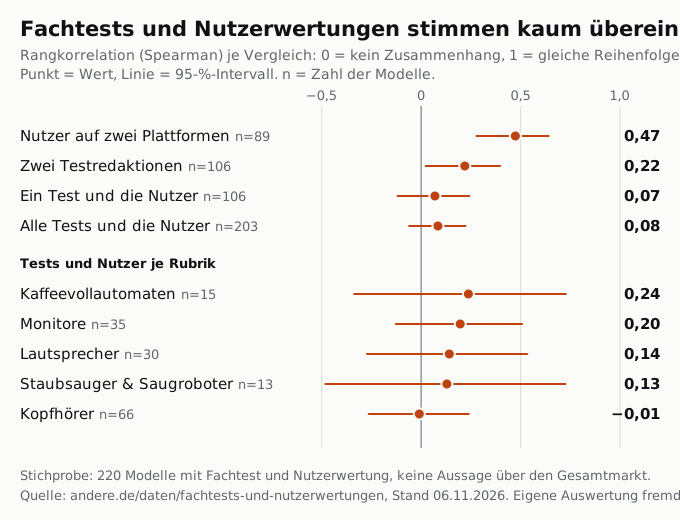
Je Rubrik
Rubriken mit mindestens 13 Modellen. Unter 30 Modellen sind die Intervalle sehr breit, einzelne Werte also nur grobe Hinweise.
| Rubrik | Modelle | Korrelation | 95-%-Intervall | Test (Median) | Sterne (Median) |
|---|---|---|---|---|---|
| Kaffeevollautomaten | 15 | 0,24 | −0,34 bis 0,73 | 82 | 4,4 |
| Monitore | 35 | 0,20 | −0,13 bis 0,51 | 86 | 4,4 |
| Lautsprecher | 30 | 0,14 | −0,27 bis 0,53 | 81 | 4,6 |
| Staubsauger & Saugroboter | 13 | 0,13 | −0,48 bis 0,73 | 80 | 3,8 |
| Kopfhörer | 66 | −0,01 | −0,26 bis 0,24 | 82 | 4,2 |
Unter den großen Rubriken gehen Tests und Nutzerwertungen bei Monitoren am ehesten in dieselbe Richtung, bei Kopfhörern ist kein Zusammenhang erkennbar. Den Abstand werten wir nur als Hinweis: Das 95-%-Intervall der Differenz (−0,20 bis 0,60) schließt die Null ein, und wir haben dieses Paar erst nach dem Blick in die Daten als größten Abstand ausgewählt.
Wie sich Tests und Nutzerwertungen auf die Drittel verteilen
Jedes Modell wurde innerhalb seiner Rubrik einmal nach Test und einmal nach Sternen in Drittel eingeordnet. Ohne Zusammenhang wäre jedes Feld etwa gleich groß, bei perfekter Übereinstimmung stünden alle Modelle auf der Diagonale. Tatsächlich landen 39 % im selben Drittel (Zufall: 33 %) und 20 % in entgegengesetzten Dritteln (Zufall: 22 %).
| Test ↓ / Nutzer → | unteres Drittel | mittleres Drittel | oberes Drittel |
|---|---|---|---|
| oberes Drittel | 21 | 23 | 24 |
| mittleres Drittel | 18 | 29 | 23 |
| unteres Drittel | 27 | 18 | 20 |
Beispiele für große Abstände
Nur sichtbare Modelle mit mindestens zwei Tests und 100 Stimmen, damit ein einzelner Ausreißer die Liste nicht füllt. Beispiele sind keine Kaufempfehlung und keine Bewertung: Die Quellen stehen jeweils auf der Produktseite.
In Tests weit vorn, bei Bewertenden weit hinten (innerhalb der Rubrik)
| Modell | Rubrik | Tests (Mittel) | Anzahl | Sterne | Stimmen |
|---|---|---|---|---|---|
| ASUS ROG Cetra True Wireless SpeedNova | Kopfhörer | 90 | 2 | 3,7 | 247 |
| Bose QuietComfort Ultra Earbuds (2. Gen.) | Kopfhörer | 93 | 3 | 4,0 | 3.597 |
| EIZO FlexScan EV2795 | Monitore | 91 | 2 | 4,2 | 145 |
| Bose QuietComfort Ultra Headphones (2. Gen.) | Kopfhörer | 93 | 4 | 4,2 | 3.072 |
Bei Bewertenden weit vorn, in Tests weit hinten (innerhalb der Rubrik)
| Modell | Rubrik | Tests (Mittel) | Anzahl | Sterne | Stimmen |
|---|---|---|---|---|---|
| Motorola Moto Buds Loop (Trekking Green) | Kopfhörer | 71 | 3 | 4,6 | 138 |
| JLab JBuds Lux ANC | Kopfhörer | 74 | 2 | 4,5 | 9.151 |
| Dreame L50 Ultra AE | Staubsauger & Saugroboter | 64 | 2 | 4,2 | 530 |
| Marshall Major V | Kopfhörer | 79 | 6 | 4,7 | 4.888 |
Einordnung: Das Muster ist bekannt
Dass Sterne und Tests nur lose zusammenhängen, haben auch andere gefunden. Eine Studie der TU Dortmund verglich 2018 Amazon-Wertungen mit Urteilen der Stiftung Warentest: Bei 1.322 Produkten in 224 Kategorien war der Testsieger nur in 69 Kategorien auch der Bestbewertete. De Langhe, Fernbach und Lichtenstein kamen 2016 für die USA (1.272 Produkte, Consumer Reports gegen Amazon) laut Pressemitteilung auf die oben genutzte Kennzahl von 57 %. Die Zahlen sind wegen anderer Produkte, Jahre und Tests nicht direkt vergleichbar.
Unsere Auswertung ist kleiner als diese Studien und nicht begutachtet. Sie ergänzt dreierlei: viele Redaktionen statt eines einzelnen Prüfinstituts, den Vergleich von Test gegen Test und Nutzerwertung gegen Nutzerwertung als Maßstab sowie aktuelle Modelle mit offenen Rohdaten.
Stichprobe
Von 1.649 ausgewerteten Produktseiten haben 487 mindestens einen Test genau dieses Modells mit Punktzahl und 1.113 eine zählende Nutzerwertung. Beides zusammen haben 221. 1 davon haben wir als Dublette, Zubehör oder wegen falscher Rubrik entfernt. Es bleiben 220 Modelle mit 444 Tests aus rund 100 Quellen. Der Median liegt bei 366 Stimmen je Modell. Ausgeblendete Modelle bleiben in der Auswertung, auch die mit schwachen Tests.
Methode
- Testwert: einfacher Mittelwert aller Tests genau dieses Modells mit Punktzahl (0 bis 100). Tests ganzer Modellreihen und Sammelwerte von Vergleichsportalen zählen nicht. Unseren Meta-Score nutzen wir hier bewusst nicht, weil er zu 30 % aus den Nutzerwertungen besteht und deshalb automatisch mit ihnen zusammenhinge.
- Nutzerwert: nach Stimmen gewichtetes Sternemittel aller zählenden Wertungen. Das heißt mindestens 15 Stimmen, nicht über Modelle gebündelt, keine Spiegelungen und nicht überwiegend aus dem Ausland oder von Vine-Testern.
- Korrelation: Spearman-Rangkorrelation, weil Tests und Sterne verschiedene Skalen haben. Für das Gesamtergebnis ordnen wir jedes Modell innerhalb seiner Rubrik ein (ab 5 Modellen) und legen die Ränge zusammen. Ohne Rubriktrennung ergibt sich 0,11 (95-%-Intervall −0,02 bis 0,24).
- Test gegen Test: Modelle mit mindestens zwei unabhängigen Quellen (106). Je Durchgang werden zwei Quellen zufällig gezogen und verglichen, Mittel aus 200 Durchgängen. Zur Fairness steht derselbe eine Test auch den Nutzerwertungen gegenüber. Dieselbe Redaktion, derselbe Verlag oder dieselbe Testreihe (etwa ADAC, ÖAMTC, TCS) gelten als eine Quelle. Der Abstand zwischen beiden Werten ist nicht gesichert (95-%-Intervall −0,12 bis 0,42), er kann auch null sein.
- Nutzerwertung gegen Nutzerwertung: die zwei größten zählenden Wertungen verschiedener Plattformen desselben Modells, also ein Maßstab dafür, wie einig sich Bewertende sind.
- Intervalle: Bootstrap mit 4.000 Wiederholungen und festem Zufallsstart, das Ergebnis ist damit reproduzierbar.
Hält das Ergebnis, wenn man die Auswahl ändert?
| Variante | Modelle | Korrelation | 95-%-Intervall |
|---|---|---|---|
| Mindestens zwei Tests | 95 | 0,15 | −0,09 bis 0,36 |
| Mindestens drei Tests | 51 | 0,05 | −0,27 bis 0,38 |
| Mindestens 200 Stimmen | 125 | 0,07 | −0,11 bis 0,26 |
| Mindestens 1.000 Stimmen | 46 | 0,04 | −0,28 bis 0,35 |
| Nur sichtbare Produkte | 202 | 0,08 | −0,07 bis 0,22 |
| Ohne Reifen | 203 | 0,08 | −0,07 bis 0,23 |
| Nur Amazon-Wertungen | 143 | 0,12 | −0,05 bis 0,27 |
| Auch Wertungen unter 15 Stimmen | 203 | 0,08 | −0,06 bis 0,22 |
| Punkte je Redaktion angeglichen | 203 | 0,16 | 0,01 bis 0,29 |
Keine Variante kommt über einen schwachen Zusammenhang hinaus. Nähmen wir auch Wertungen mit weniger als 15 Stimmen hinein, die manche unserer Seiten mitführen, läge der Wert bei 0,08. Unsere veröffentlichte Regel zählt sie nicht, deshalb tun wir es hier auch nicht. Die Redaktionen vergeben im Schnitt auch unterschiedlich hohe Punktzahlen. Gleichen wir das an, steigt der Wert für zwei Testredaktionen auf 0,24 und der für einen Test und die Nutzerwertungen auf 0,12; die Reihenfolge bleibt.
Grenzen
- Kein Abbild des Marktes. Die Modelle stammen aus unserem Katalog: mindestens drei Shops, bekannte Marke, und es gibt überhaupt einen Test. Über alle Produkte in Deutschland sagen die Zahlen nichts.
- Eingeschränkte Spanne. Fast alle Modelle haben 4 Sterne oder mehr, und unser Katalog enthält nur breit geführte Modelle. In einer so engen Spanne fällt jede Korrelation niedriger aus. Es kann also sein, dass Tests und Nutzerwertungen über die ganze Breite des Marktes besser übereinstimmen, zum Beispiel beim Erkennen wirklich schlechter Geräte.
- Tests sind nicht einheitlich. Die Skalen, Prüfverfahren und das Alter unterscheiden sich, die Tests stammen überwiegend aus 2023 bis 2026. Das drückt jede Korrelation, auch die zwischen zwei Redaktionen.
- Nutzerwertungen prüfen wir nicht. Ob die Stimmen echt sind oder von Personen stammen, die das Produkt gekauft oder genutzt haben, können wir nicht feststellen. 98 % der Stimmen stammen von Amazon.
- Erfassung. Die Werte wurden mit KI-Unterstützung von den verlinkten Seiten übernommen. Am 06.11.2026 haben wir zwölf zufällig gezogene Testwerte an der Quelle gegengelesen: Zehn stimmten, zwei ließen sich nicht prüfen (Seite gesperrt, Note nicht auffindbar), eine Abweichung fanden wir nicht. Nutzerwertungen waren nicht Teil dieser Stichprobe, und zwölf Werte sind nur ein grober Hinweis. Übertragungsfehler bleiben möglich: Wenn dir einer auffällt, schreib uns (siehe Impressum).
- Viele Vergleiche. Bei 5 Rubriken und mehreren Varianten ist einzelnes Auffälliges auch Zufall. Die Auswertung war nicht vorab festgelegt, sie ist explorativ.
Was daraus nicht folgt
Die Zahlen sagen nicht, wer recht hat. Sie zeigen weder, dass Tests wertlos sind, noch, dass Bewertende sich irren, und sie erklären auch nicht, warum beide auseinanderliegen. Naheliegend, aber von uns nicht geprüft, ist: Tests messen kurz und unter festen Bedingungen, Bewertende urteilen über den Alltag, über Haltbarkeit und nach dem, was sie für ihr Geld erwartet haben. Auf unseren Produktseiten stehen beide Quellen einzeln, der Meta-Score fasst sie zu 70 % Tests und 30 % Nutzerwertungen zusammen.
Was unsere Daten noch nicht hergeben
- Preisschwankungen je Rubrik und Zeitpunkt: Unsere Preishistorie umfasst erst 20 Tage (18.10.2026 bis 06.11.2026), und am 24.10.2026 fiel die Zahl der erfassten Angebote von 101.616 auf 81.664. Das spricht für eine Änderung im Datenbestand, nicht für eine Marktbewegung. Saison und Wochentag lassen sich damit nicht trennen. Belastbar wird das frühestens nach dem Black Friday für diesen einen Tag und ab Mitte Januar 2027 (mindestens acht Wochen Daten) für den Verlauf.
- „Sind teurere Produkte besser?“ Testwert und Preis hängen innerhalb der Rubriken etwas stärker zusammen als Test und Nutzerwertung (0,29, 95-%-Intervall 0,19 bis 0,38, 398 Modelle ohne Reifen). Der Preis ist aber der heutige, und Größe, Ausstattung und Alter sind nicht herausgerechnet. Einen Schluss wie „das Doppelte kostet X Punkte“ ziehen wir daraus nicht.
Rohdaten, zitieren und einbinden
Rohdaten: CSV mit allen 220 Modellen (UTF-8, Komma als Trennzeichen, Punkt als Dezimalzeichen). Testwert und Sterne jedes Modells stehen darin, das Hauptergebnis lässt sich damit nachrechnen.
Zitieren: Zitieren und Weiterverwenden der Zahlen und der Grafik ist mit Quellenangabe und Link ausdrücklich erwünscht, die Grafik darf dafür unverändert übernommen werden. Vorschlag:
andere.de: Fachtests und Nutzerwertungen stimmen kaum überein. Auswertung von 220 Modellen, Stand 06.11.2026.
https://andere.de/daten/fachtests-und-nutzerwertungen
Einbinden: Die Grafik ist eine eigenständige Datei, sie lädt nichts nach und setzt keine Cookies.
<a href="https://andere.de/daten/fachtests-und-nutzerwertungen">
  <img src="https://andere.de/static/daten/fachtests-und-nutzerwertungen.svg" width="680" alt="Fachtests und Nutzerwertungen stimmen kaum überein. Quelle: andere.de">
</a>
Interessenlage: andere.de finanziert sich über Provisionen der verlinkten Shops. Die Auswertung hängt nicht an der Provision, und die Beispiele oben ergeben sich allein aus den genannten Regeln.